Les discussions sur l’infrastructure d’IA sont dominées par la puissance de calcul.
Les GPU.
L’énergie.
Le refroidissement.
Les centres de données.
La mémoire.
Le stockage.
L’interconnexion.
Tous ces éléments comptent.
Mais une autre couche d’infrastructure reçoit bien moins d’attention :
Les ressources de numérotation Internet.
Une entreprise d’IA peut posséder des GPU, sécuriser des contrats d’énergie, déployer de la fibre à grande capacité et construire une infrastructure sophistiquée de mise à disposition des modèles.
Mais si les clients ne peuvent pas accéder de manière fiable à cette infrastructure, toute cette puissance de calcul ne sert à rien.
Les systèmes d’IA destinés au public dépendent toujours de l’infrastructure Internet.
Les API de modèles ont besoin de points de terminaison.
Les clouds de GPU ont besoin d’une connectivité client.
Les centres de données ont besoin de réseaux routés.
Les plateformes d’IA d’entreprise ont besoin d’intégrations stables.
Les systèmes de sécurité peuvent dépendre d’identités réseau connues.
Les services multirégionaux peuvent exiger un routage indépendant.
Derrière ces systèmes se trouvent des adresses IPv4 et IPv6, des numéros de système autonome, des politiques de routage, des données de registre et des assertions de sécurité.
Pour les entreprises d’IA, les adresses IP ne doivent donc pas être reléguées au second plan.
Elles font partie de la pile d’infrastructure.
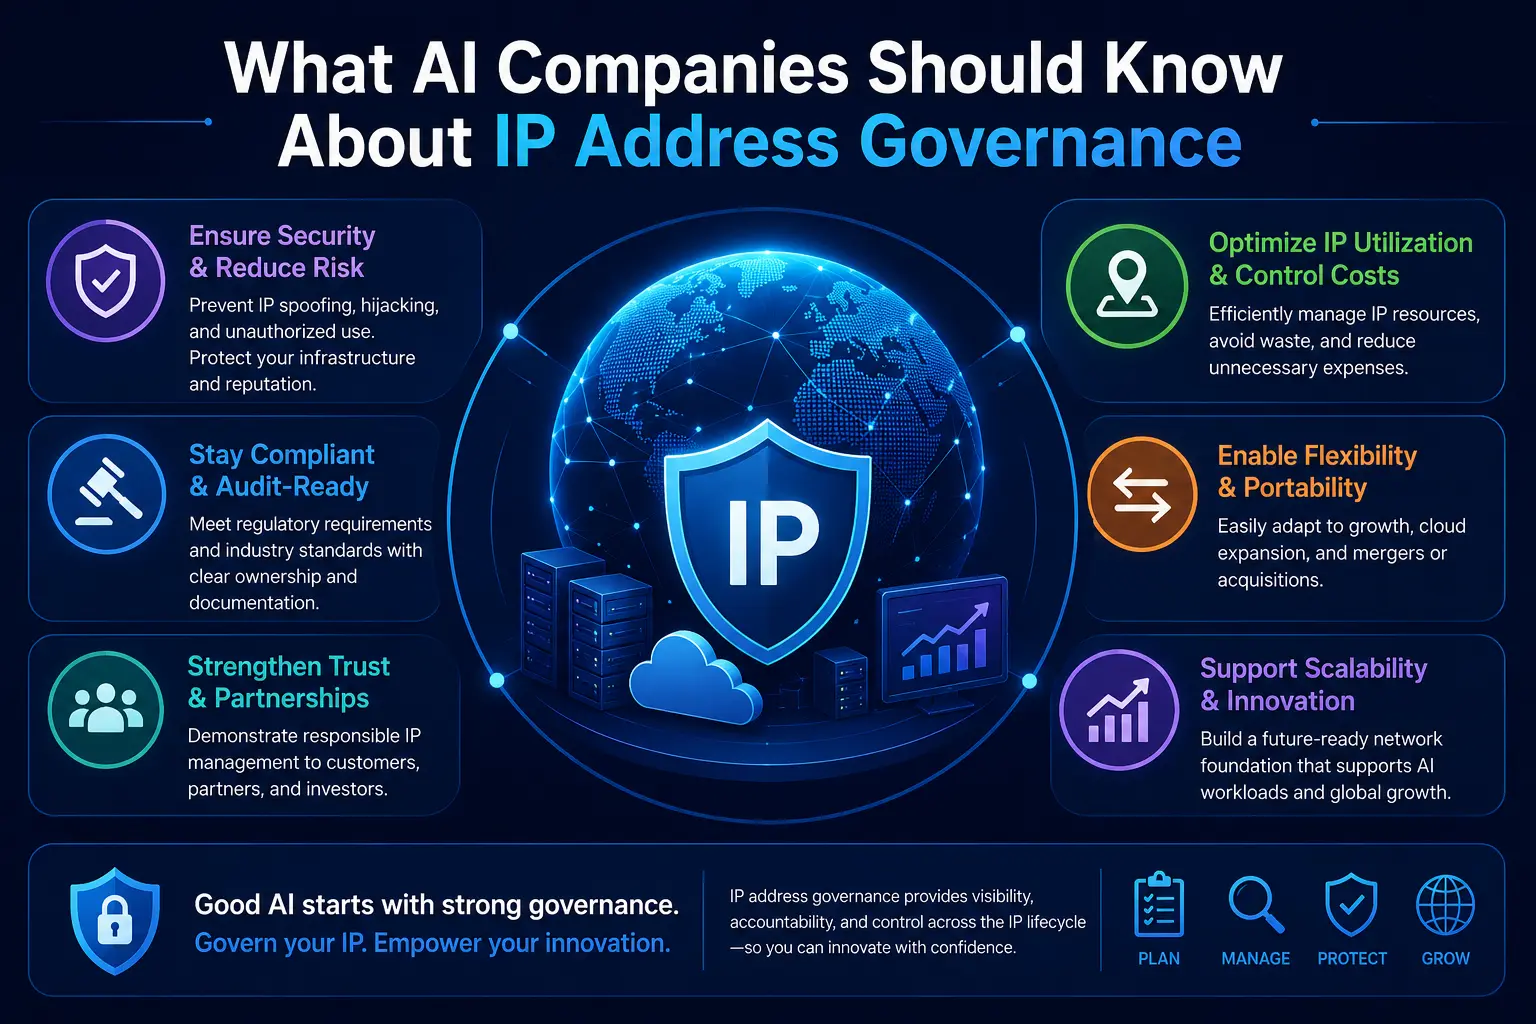
Et dès qu’une ressource de numérotation s’intègre aux opérations, la gouvernance des adresses IP devient une question de continuité d’activité.
L’infrastructure d’IA est aussi une infrastructure Internet
Une entreprise d’IA peut se voir avant tout comme une entreprise de logiciels ou de calcul.
Sur le plan opérationnel, de nombreuses entreprises d’IA ressemblent pourtant de plus en plus à des entreprises d’infrastructure.
Prenons une plateforme d’IA qui exploite :
- Des API publiques de modèles
- Des services cloud de GPU
- Une infrastructure d’inférence d’entreprise
- Des grappes d’entraînement
- Des tableaux de bord destinés aux clients
- Des réseaux privés
- Des centres de données multirégionaux
- Des passerelles cloud
- Des intégrations avec des partenaires
Chacun de ces systèmes finit par interagir avec des identifiants réseau.
Au niveau élémentaire, les adresses IP publiques indiquent où les services sont accessibles sur Internet.
À un niveau plus profond, ces adresses peuvent être liées à :
- Le DNS
- Les listes d’autorisation des clients
- Les pare-feu
- Les VPN
- La sécurité des API
- Le routage
- La géolocalisation
- Les systèmes de gestion des abus
- La surveillance
- Les bases de données de réputation
Une adresse IP peut commencer comme une simple capacité.
Avec le temps, elle peut devenir une identité.
Cette distinction est extrêmement importante pour les entreprises d’IA qui développent rapidement leur infrastructure.
La première chose que les entreprises d’IA doivent comprendre : les adresses IP sont des ressources coordonnées
Les ressources publiques de numérotation Internet ne sont pas des numéros indépendants choisis par chaque entreprise.
Elles s’inscrivent dans un cadre mondial de coordination.
L’ Internet Assigned Numbers Authority (IANA) tient les registres mondiaux de l’IPv4, de l’IPv6 et des numéros de système autonome, tandis que les ressources de numérotation sont administrées par le système des registres Internet régionaux.
Cette architecture existe pour une raison technique importante :
Les identifiants Internet doivent rester uniques à l’échelle mondiale.
Le RFC 7020 décrit le système de registre des numéros Internet utilisé pour l’espace d’adresses IP et les numéros AS uniques à l’échelle mondiale.
Pour les entreprises d’IA, l’unicité elle-même ne fait pas débat.
Deux réseaux de production sans lien ne peuvent pas tous deux revendiquer de manière exclusive et incompatible le même préfixe routé mondialement.
La question de gouvernance la plus importante commence une fois l’unicité établie :
Quelle autorité la couche de coordination doit-elle exercer sur la vie commerciale et opérationnelle d’une ressource de numérotation déjà en service ?
C’est là que le problème se complique.
Une inscription au registre n’est pas la même chose qu’un réseau en fonctionnement
L’une des distinctions les plus importantes qu’une équipe d’infrastructure d’IA doit comprendre sépare :
Les informations du registre
et
la réalité opérationnelle d’Internet.
Un registre peut tenir des informations sur un bloc IPv4.
Mais une entrée de base de données ne déplace pas elle-même les paquets.
BGP échange les informations de routage entre les réseaux.
Les routeurs appliquent des politiques.
Les fournisseurs en amont propagent les annonces.
RPKI peut fournir des informations de sécurité indiquant quel ASN est autorisé à être à l’origine d’un préfixe.
Les applications et les clients dépendent ensuite de la connectivité qui en résulte.
C’est pourquoi j’ai soutenu que :
Une inscription au registre décrit la réalité ; elle ne la crée pas.
Le registre doit contribuer à maintenir l’exactitude du registre partagé.
Il doit préserver l’unicité.
Il doit consigner les changements légitimes.
Il doit soutenir la sécurité et la coordination opérationnelle.
Mais l’existence d’une base de données ne doit pas être confondue avec la propriété de la réalité économique et opérationnelle construite autour des ressources qu’elle recense.
Cette distinction est approfondie dans La Déclaration des droits de la coordination de l’unicité, où je soutiens que la couche commune des ressources de numérotation doit rester centrée sur l’unicité, l’exactitude des données, la preuve du contrôle, les assertions de sécurité, l’auditabilité et la continuité opérationnelle.
Pour les entreprises d’IA qui construisent des infrastructures coûteuses autour des ressources IP, cette distinction n’est pas philosophique.
Elle relève de la gestion des risques.
La rareté de l’IPv4 change la question de gouvernance
IPv4 diffère d’une ressource logicielle ordinaire.
Une entreprise peut créer une autre base de données.
Elle peut provisionner des machines virtuelles supplémentaires.
Elle peut fabriquer ou acheter davantage de matériel si l’offre le permet.
Elle ne peut pas fabriquer un autre Internet IPv4 mondialement unique.
IPv4 est fini.
Dès que la rareté acquiert une importance économique, les ressources de numérotation cessent de ressembler à des jetons administratifs.
Elles deviennent des actifs opérationnels.
C’est particulièrement pertinent pour l’infrastructure d’IA.
Supposons qu’une entreprise de cloud d’IA ait besoin de milliers d’adresses IPv4 publiques pour :
- Les charges de travail des clients
- Les passerelles publiques
- Les API
- L’infrastructure de gestion
- Les points de terminaison dédiés
- Les équipements de sécurité
- Les services régionaux
Sa stratégie IPv4 peut reposer sur :
- Des attributions existantes
- Des ressources achetées
- Des transferts
- De la location
- Des adresses attribuées par un fournisseur
- Des dispositifs d’apport de ses propres adresses IP
Ces structures créent des dépendances différentes.
La question n’est donc pas simplement :
« De combien d’adresses IP avons-nous besoin ? »
La meilleure question est :
« Dans quelle structure de gouvernance ces adresses resteront-elles utilisables ? »
Les entreprises d’IA doivent séparer la capacité de l’identité
C’est peut-être la distinction d’infrastructure la plus importante.
Toutes les adresses IP n’ont pas la même valeur pour une entreprise.
Certaines adresses sont jetables.
Une charge de développement temporaire peut passer d’une adresse à une autre sans grande conséquence.
D’autres adresses s’intègrent progressivement en profondeur.
Imaginons un fournisseur d’API d’IA.
Ses clients professionnels placent des adresses sources précises sur liste d’autorisation.
Les banques et les clients réglementés configurent leurs contrôles de sécurité autour de ces adresses.
Les partenaires les documentent.
Les systèmes de surveillance accumulent des années d’historique autour d’elles.
Les pare-feu en dépendent.
Les systèmes internes de conformité les référencent.
À ce stade, l’adresse n’est plus une simple capacité.
Elle est devenue une composante de l’ identité réseau.
J’ai développé cette distinction dans À propos de LARUS One — L’économie de l’identité réseau, de la continuité client et des revenus des fournisseurs. L’idée centrale est simple : le véritable coût d’une adresse importante n’est souvent pas son prix, mais le coût de son remplacement.
Les entreprises d’IA doivent déterminer tôt quelles adresses ne sont que de la capacité et lesquelles deviennent une identité.
Elles ne doivent pas gouverner les deux catégories de la même manière.
Posez la bonne question : que coûterait une renumérotation ?
Les équipes d’infrastructure demandent souvent :
Combien coûte l’IPv4 ?
C’est une question d’achat.
Pour les infrastructures critiques, une autre question peut être plus importante :
Que coûterait le remplacement de ces adresses ?
Prenons une plateforme d’IA mature qui sert des clients dans le monde entier.
Le changement d’un préfixe public central pourrait imposer de mettre à jour :
- Les données DNS
- Les politiques de pare-feu
- Les listes d’autorisation des clients
- Les listes d’autorisation des partenaires
- Les paramètres de sécurité des API
- Les configurations VPN
- BGP
- RPKI
- La surveillance
- Le DNS inverse
- Les données de géolocalisation
- Les documents de conformité
Certaines modifications peuvent être automatisées.
D’autres exigent une action des clients ou partenaires.
Cela crée une dépendance externe.
Plus les systèmes externes reconnaissent une adresse, plus sa renumérotation devient coûteuse.
Pour les entreprises d’IA en forte croissance, ce coût doit être modélisé avant que l’infrastructure ne soit profondément intégrée.
Votre ASN compte aussi
Les adresses IP ne sont qu’un élément de l’identité réseau.
Les grands opérateurs d’infrastructures d’IA peuvent aussi utiliser des numéros de système autonome.
Un ASN devient particulièrement pertinent lorsqu’une entreprise applique des politiques de routage indépendantes ou se connecte par plusieurs fournisseurs.
Une architecture simplifiée pourrait être :
Infrastructure d’IA → propre préfixe IPv4 → propre ASN → plusieurs réseaux en amont
Cela peut offrir plus d’indépendance de routage qu’une dépendance totale à l’adressage attribué par un fournisseur.
Mais l’indépendance crée aussi des responsabilités.
Un opérateur doit comprendre :
- La politique BGP
- Les annonces de routes
- Le filtrage des préfixes
- RPKI
- Les informations IRR
- Les relations en amont
- La réponse aux incidents
Une entreprise d’IA n’a pas besoin de devenir spécialiste de la gouvernance d’Internet simplement parce qu’elle exploite un ASN.
Mais quelqu’un dans l’organisation doit comprendre cette dépendance.
Un ASN ne doit pas devenir un numéro oublié dans une feuille de calcul jusqu’au jour où le routage tombe en panne.
Les entreprises d’IA doivent comprendre RPKI
RPKI est l’un des mécanismes de sécurité du routage les plus importants liés aux ressources de numérotation Internet.
Une autorisation d’origine de route, ou ROA, permet au titulaire d’une ressource d’indiquer quel ASN est autorisé à être à l’origine d’un préfixe.
RIPE NCC décrit une ROA comme un objet RPKI signé qui autorise un ASN d’origine à annoncer un ou plusieurs préfixes, avec éventuellement une longueur maximale de préfixe.
Pour un opérateur d’infrastructure d’IA, cela compte chaque fois que l’architecture de routage change.
Supposons que votre entreprise d’IA :
- Acquière un bloc IPv4.
- Le déploie depuis l’ASN 64500.
- Crée la ROA appropriée.
- Passe ensuite à l’ASN 64501.
- Mette à jour BGP mais oublie la ROA.
La route peut être légitime sur le plan opérationnel.
Mais l’assertion de sécurité est obsolète.
Les réseaux qui effectuent une validation de l’origine des routes peuvent considérer la nouvelle route comme invalide.
La leçon est simple :
RPKI doit suivre la réalité du réseau en fonctionnement.
Les changements du réseau et ceux du registre ou de la sécurité doivent donc appartenir au même processus opérationnel.
L’infrastructure de sécurité ne doit pas devenir un levier de gouvernance
RPKI est précieux précisément parce qu’il répond à une question technique limitée :
Cet ASN est-il autorisé à être à l’origine de ce préfixe ?
Cette portée limitée est une force.
L’infrastructure de sécurité devient dangereuse lorsqu’elle sert de mécanisme général pour imposer des décisions sans rapport.
Un désaccord sur :
- La structure commerciale
- La location
- La localisation des clients
- Le modèle économique
- La politique institutionnelle
n’est pas automatiquement un problème de sécurité du routage.
RPKI doit refléter une autorisation technique légitime.
Il ne doit pas devenir une couche de sanction pour un désaccord institutionnel sans rapport.
Ce principe découle du cadre plus large que je décris dans La primauté du code opérationnel: les systèmes de coordination doivent être interprétés selon la fonction technique minimale dont les réseaux en fonctionnement ont réellement besoin.
La propre déclaration de mission de l’IETF fournit ici un contexte utile. Le RFC 3935 décrit la tradition du consensus approximatif et du code opérationnel, qui ancre la légitimité technique dans le jugement d’ingénierie et la mise en œuvre réelle.
Pour les entreprises d’IA, la traduction pratique est la suivante :
La sécurité doit sécuriser le réseau. La gouvernance ne doit pas transformer l’infrastructure de sécurité en point d’étranglement sans rapport.
L’achat d’IPv4 n’élimine pas automatiquement le risque de gouvernance
Une entreprise d’IA peut répondre à sa dépendance envers l’IPv4 en décidant :
Nous devrions simplement acheter nos adresses.
Un contrôle proche de la propriété peut apporter des avantages importants.
Mais l’achat ne fait pas disparaître la couche des registres.
Après l’acquisition d’IPv4, l’entreprise peut encore dépendre de :
- Les données du registre
- Les procédures de transfert
- Les services RPKI
- Le DNS inverse
- L’accès au compte
- Les contacts administratifs
- Les contrats du registre
- La continuité institutionnelle
Cela signifie que l’entreprise a déplacé le risque.
Elle ne l’a pas nécessairement éliminé.
Cela ne signifie pas que l’achat d’IPv4 soit une erreur.
Cela signifie que les achats doivent distinguer :
l’acquisition commerciale
et
l’architecture de continuité.
Une transaction signée peut établir une position commerciale.
Elle ne répond pas automatiquement à toutes les questions sur le routage futur, la continuité du registre, les services de sécurité ou la dépendance institutionnelle.
La location d’IPv4 soulève aussi des questions de gouvernance
Il en va de même pour la location.
Une entreprise d’IA peut louer de l’IPv4 parce qu’elle recherche :
- Un coût initial plus faible
- Un déploiement rapide
- Une capacité flexible
- Une expansion multirégionale
- Des besoins temporaires en adresses
Cela peut être parfaitement rationnel.
Mais l’entreprise doit savoir :
- Qui contrôle réellement la ressource d’adressage ?
- Le fournisseur est-il direct ou passe-t-il par un courtier ?
- Quel ASN peut être à l’origine du préfixe ?
- Qui crée la ROA ?
- Qui contrôle le DNS inverse ?
- Que se passe-t-il si la réputation se dégrade ?
- Qui traite les abus ?
- Que se passe-t-il au renouvellement ?
- Que se passe-t-il si la relation en amont liée à la ressource échoue ?
Le pire moment pour découvrir ces dépendances est celui où les adresses sont déjà devenues une identité réseau critique.
La question du courtier est en réalité une question de risque
C’est pourquoi le vocabulaire ordinaire des achats peut induire en erreur.
Le marché demande :
Qui peut nous procurer de l’IPv4 ?
Un opérateur d’infrastructure d’IA doit demander :
Qui supporte le risque derrière l’IPv4 ?
Une place de marché peut afficher un stock.
Un courtier peut présenter une contrepartie.
Un contrat peut décrire des conditions.
Mais les entreprises d’IA qui construisent une infrastructure de production doivent comprendre ce qui se passe après la transaction.
Si les adresses s’intègrent aux systèmes des clients, leur valeur dépend de plus en plus de la continuité.
C’est pourquoi j’ai soutenu dans Pourquoi i.LEASE existe — et pourquoi la question du courtier est en réalité une question de risque lié au registre que l’exécution liée à l’IPv4 doit être évaluée selon la structure de risque sous-jacente à la transaction visible.
Le même principe s’applique aux entreprises d’IA.
N’évaluez pas l’approvisionnement en IPv4 uniquement selon :
Le prix par adresse.
Évaluez aussi :
La continuité par adresse.
La portabilité doit compter pour les équipes d’infrastructure d’IA
L’une des plus grandes faiblesses structurelles de la gouvernance des ressources de numérotation Internet est l’absence de mécanisme universel de portabilité au niveau de la ressource.
Je distingue la portabilité des ressources de la migration ordinaire d’une entreprise ou d’un membre.
La question n’est pas :
L’entreprise peut-elle déménager ?
Elle n’est pas :
L’entreprise peut-elle rejoindre une autre organisation ?
La question est :
La ressource de numérotation précise peut-elle préserver son administration au registre, la preuve du contrôle, les assertions de sécurité et la continuité opérationnelle si la structure administrative actuelle échoue ?
Cette distinction compte pour l’infrastructure d’IA.
Imaginons qu’une entreprise d’IA ait construit une grande plateforme client autour d’un bloc IPv4 stable.
Si l’institution de registre qui l’entoure connaît :
- Un effondrement de la gouvernance
- Une insolvabilité
- Une paralysie juridique
- Une défaillance technique
- Un conflit grave
l’entreprise doit-elle renuméroter son infrastructure simplement parce que le prestataire administratif est devenu instable ?
Ma position est que non.
Un réseau en fonctionnement a besoin d’une voie de continuité.
C’est pourquoi La Déclaration des droits de la coordination de l’unicité inclut la portabilité comme principe de conception fondamental.
Protéger la fonction de registre, non l’immortalité institutionnelle
Cette distinction est particulièrement pertinente pour les entreprises d’IA, car leur infrastructure devient plus coûteuse et plus importante sur le plan opérationnel.
Une entreprise peut dépenser des milliards pour construire sa capacité de calcul.
Il serait irrationnel de concevoir la couche d’identité réseau de façon qu’elle dépende de la santé institutionnelle permanente d’une seule organisation.
Les fonctions de registre comptent.
Elles comprennent :
- L’unicité des numéros
- L’exactitude des données
- RDAP/WHOIS
- Le DNS inverse
- RPKI
- L’historique des transferts
- Les métadonnées de sécurité
Mais la continuité de ces fonctions n’exige pas logiquement l’immortalité institutionnelle.
Je développe cet argument dans Le sophisme de la continuité des registres — Protéger le registre partagé, non le gardien.
Le principe est simple :
Protéger le registre partagé.
Protéger la chaîne de sécurité.
Protéger le réseau en fonctionnement.
Protéger les clients.
L’institution qui administre ces fonctions doit rester remplaçable.
Pour les entreprises d’IA, il s’agit d’une règle élémentaire d’ingénierie des infrastructures.
Nous exigeons une relève pour le calcul.
Nous exigeons une relève pour l’énergie.
Nous exigeons une relève pour le stockage.
Nous exigeons une relève pour la connectivité.
Pourquoi la couche des ressources de numérotation en serait-elle exemptée ?
Les entreprises d’IA doivent traiter le risque lié aux registres comme les autres risques d’infrastructure
Un registre mature des risques d’infrastructure d’IA peut déjà inclure :
- L’approvisionnement en GPU
- La disponibilité de l’énergie
- La concentration des centres de données
- La défaillance du transit
- La concentration du cloud
- La cybersécurité
- La défaillance matérielle
- Le risque fournisseur
Ajoutez-y :
Le risque lié aux ressources de numérotation Internet.
Ce risque comprend plusieurs catégories.
Risque administratif
Qui contrôle les comptes et identifiants nécessaires à la gestion des ressources ?
Risque lié au registre
Quelles dépendances institutionnelles entourent les ressources ?
Risque de routage
Quels ASN annoncent les préfixes ?
Risque RPKI
Les assertions de sécurité correspondent-elles à la réalité du routage ?
Risque fournisseur
Le réseau dépend-il d’adresses attribuées par un fournisseur ?
Risque de renouvellement
Les adresses louées pourraient-elles disparaître à l’expiration du contrat ?
Risque d’identité
Combien de clients et partenaires dépendent d’adresses précises ?
Risque de portabilité
Que se passe-t-il si le service administratif doit changer ?
Ces questions sont mineures par rapport au budget de calcul d’une entreprise d’IA.
Leurs conséquences peuvent ne pas l’être.
Les équipes d’infrastructure d’IA ont besoin de leur propre inventaire de ressources de numérotation
Toute entreprise sérieuse d’infrastructure d’IA doit pouvoir répondre à la question :
De quelles ressources de numérotation Internet dépendons-nous ?
Cet inventaire doit inclure :
- Les préfixes IPv4
- Les préfixes IPv6
- Les ASN
- Le titulaire de la ressource
- Le registre
- L’ASN d’origine
- Le statut RPKI
- L’autorité sur le DNS inverse
- La structure de location ou de propriété
- La date de renouvellement
- Les fournisseurs en amont
- Les clients critiques
- Les listes d’autorisation externes
- Les propriétaires des comptes administratifs
Ne conservez pas ces informations uniquement dans la tête d’un ingénieur réseau.
Traitez-les comme des métadonnées d’infrastructure.
L’entreprise doit pouvoir survivre aux changements de personnel sans perdre le contrôle de ses ressources de numérotation.
Les entreprises d’IA doivent classer les adresses IP par criticité
Toutes les adresses n’exigent pas une protection maximale de leur continuité.
Créez des catégories.
Capacité jetable
Exemples :
- Environnements de développement
- Tests temporaires
- Expériences à court terme
Le coût de renumérotation est faible.
Capacité de production
Exemples :
- Charges de travail des clients
- Infrastructure applicative générale
- Services cloud régionaux
La continuité compte, mais le remplacement peut rester gérable.
Identité critique pour l’activité
Exemples :
- Principaux points de terminaison d’API
- Passerelles destinées aux partenaires
- Infrastructure réglementée
- Adresses inscrites sur des listes d’autorisation de sécurité
- Systèmes liés aux paiements
- Réseaux clients essentiels
La renumérotation peut nécessiter une coordination externe importante.
Identité impossible à renuméroter ou au coût de renumérotation extrêmement élevé
Cette catégorie devrait rester rare.
Mais lorsqu’une adresse est intégrée aux systèmes des clients, de sécurité, des partenaires, aux environnements de conformité et à plusieurs fournisseurs, le coût de sa modification peut dépasser celui du maintien d’une architecture dédiée à la continuité.
Les dépenses d’infrastructure devraient suivre cette classification.
La réponse IPv6 ne suffit pas
Les entreprises d’IA devraient déployer IPv6 lorsqu’il est pertinent sur les plans technique et commercial.
Mais IPv6 ne fait pas disparaître du jour au lendemain la question de la gouvernance d’IPv4.
Une plateforme d’IA peut encore interagir avec :
- Des clients uniquement compatibles IPv4
- Des réseaux d’entreprise anciens
- Des produits de sécurité
- Des systèmes partenaires
- Des services externes
- Des listes d’autorisation de clients
La bonne question de planification n’est pas :
« IPv4 ou IPv6 ? »
Mais :
« Quelles charges de travail nécessitent encore IPv4, lesquelles peuvent fonctionner avec IPv6 et quel niveau de continuité exige chaque identité ? »
C’est une décision d’infrastructure.
Elle ne devrait pas être réduite à une opposition idéologique entre deux protocoles.
La géographie ne devrait pas devenir un titre de propriété
L’infrastructure d’IA est par nature mondiale.
Un modèle peut être entraîné dans un pays.
Son API peut fonctionner dans un autre.
Ses clients peuvent se trouver partout.
Le trafic peut traverser des réseaux sur plusieurs continents.
L’administration des adresses IP peut être historiquement associée à un registre Internet régional particulier.
Mais la géographie de la région de service ne doit pas être confondue avec la maîtrise du destin économique de la ressource.
Ce point est particulièrement important pour les entreprises d’IA mondiales.
Internet assure un routage mondial.
Un préfixe n’acquiert pas une nationalité politique simplement parce qu’une base de données particulière l’a historiquement administré.
La couche de coordination a besoin d’enregistrements exacts.
Elle n’a pas à décider si les clients d’une entreprise d’IA sont assez locaux pour justifier l’accès à une ressource rare.
Cette distinction s’inscrit dans une idée plus générale développée dans mes notes :
Une coordination légère fonctionne. Une gouvernance lourde crée des risques inutiles.
À quoi devrait ressembler une gouvernance légère des adresses IP ?
Une couche utile de coordination des ressources de numérotation devrait répondre à un ensemble restreint de questions.
La ressource est-elle unique ?
Il ne devrait pas exister d’enregistrements en double incompatibles.
Qui démontre le contrôle ?
Le système devrait conserver une preuve crédible.
Les enregistrements sont-ils exacts ?
Les contacts et les informations sur les ressources devraient refléter la réalité.
Les assertions de sécurité sont-elles valides ?
RPKI et les mécanismes associés devraient refléter une autorisation de routage légitime.
Les changements sont-ils auditables ?
Les transferts et mises à jour devraient disposer d’un historique fiable.
Les litiges peuvent-ils être isolés ?
Un désaccord ne devrait pas détruire inutilement un réseau en fonctionnement.
Existe-t-il une voie de remplacement ?
La fonction de registre devrait survivre à la défaillance d’une institution.
Cela suffit à soutenir un Internet mondialement interopérable.
Tout le reste devrait satisfaire à un niveau d’exigence supérieur avant de devenir obligatoire.
La question devrait toujours être :
Le code en production exige-t-il réellement cette règle ?
La primauté du code en production pour l’infrastructure d’IA
Les entreprises d’IA sont particulièrement bien placées pour comprendre ce principe.
Les ingénieurs logiciels distinguent déjà :
ce que dit la spécification
et
ce que fait réellement le système.
L’infrastructure Internet devrait être abordée avec la même rigueur.
Le réseau en fonctionnement est réel.
Les clients sont réels.
Les routes sont réelles.
Les dépendances de sécurité sont réelles.
Un document de politique est utile lorsqu’il aide à coordonner cette réalité.
Il devient dangereux lorsqu’il prétend se placer au-dessus de cette réalité.
C’est pourquoi la primauté du code en production compte au-delà des entreprises de télécommunications traditionnelles.
Les entreprises d’IA deviennent des opérateurs d’infrastructure Internet.
Elles devraient hériter de la discipline technique qui a permis à Internet de fonctionner :
coordonner ce qui doit l’être ; décentraliser tout ce qui n’a pas besoin d’une décision centrale.
Liste pratique de gouvernance IP pour les entreprises d’IA
Avant d’étendre une infrastructure d’IA, posez-vous les questions suivantes :
- Quelles ressources IPv4 et IPv6 prennent en charge la production ?
- Quels ASN font partie de notre réseau ?
- Qui est enregistré comme détenteur de la ressource ?
- Quel registre administre chaque ressource ?
- Qui contrôle l’accès administratif ?
- Quel ASN annonce chaque préfixe de production ?
- Nos ROA sont-ils corrects ?
- Qui peut modifier RPKI ?
- Qui contrôle le DNS inverse ?
- Les contacts WHOIS/RDAP sont-ils exacts ?
- Quelles ressources sont louées ?
- Quelles ressources sont détenues directement ?
- Quelles ressources proviennent de fournisseurs ?
- Quelles sont les dates de renouvellement ?
- Que se passe-t-il si un bailleur fait défaut ?
- Que se passe-t-il si un registre devient indisponible ?
- Quels clients ont inscrit nos adresses sur leurs listes d’autorisation ?
- Combien coûterait la renumérotation de chaque préfixe critique ?
- La ressource est-elle seulement de la capacité ou est-elle devenue une identité ?
- Existe-t-il une voie crédible de continuité ou de remplacement ?
Si l’entreprise ne peut pas répondre à ces questions, la gouvernance de son infrastructure de ressources de numérotation n’est pas encore complète.
Ce que le conseil d’administration devrait comprendre
La gouvernance des adresses IP ne devrait plus relever exclusivement de l’équipe d’ingénierie réseau dès que l’entreprise atteint une certaine échelle.
Les conseils d’administration et les dirigeants n’ont pas besoin de comprendre la configuration BGP.
Ils devraient comprendre le modèle de risque.
Les questions pertinentes sont :
Les identités réseau critiques sont-elles stables ?
Les clients peuvent-ils rester joignables si le fournisseur change ?
Un problème de registre peut-il interrompre l’activité ?
Combien coûterait une renumérotation ?
Où se trouvent les points uniques de dépendance institutionnelle ?
Ce sont des questions de gouvernance, car elles touchent à la continuité, au capital, aux relations clients et à la flexibilité stratégique.
Ce que les investisseurs devraient demander
Les investisseurs qui procèdent à l’audit de l’infrastructure d’une entreprise d’IA devraient également examiner les ressources de numérotation.
Une bonne question d’audit ne se limite pas à :
« Disposez-vous de suffisamment d’adresses IP ? »
Demandez plutôt :
- Comment sont-elles obtenues ?
- Quelle proportion est louée ?
- Quelle proportion est détenue directement ?
- Qui supporte le risque lié au registre ?
- Quelles adresses sont critiques pour l’activité ?
- Le routage est-il contrôlé en interne ?
- Les processus RPKI et de registre sont-ils documentés ?
- Que se passe-t-il si des relations essentielles concernant les adresses prennent fin ?
Une entreprise d’IA dotée d’une puissance de calcul exceptionnelle mais d’une identité réseau fragile reste exposée à un risque de concentration de l’infrastructure.
Ce risque est simplement moins visible.
La question plus générale de gouvernance
L’IA pourrait devenir l’un des principaux nouveaux consommateurs de capitaux d’infrastructure à l’échelle mondiale.
Cela en fait une partie prenante importante de l’avenir de la gouvernance d’Internet.
Mais les entreprises d’IA ne devraient pas aborder ce débat en réclamant davantage de contrôle centralisé.
Elles devraient demander une meilleure ingénierie.
La couche des ressources de numérotation devrait être :
- Exacte
- Auditable
- Sûre
- Portable
- Remplaçable
- Résistante à la captation
- Centrée sur la continuité
Internet a effectivement besoin de coordination.
Il n’a pas besoin d’une souveraineté inutile sur les identifiants.
Cette distinction comptera davantage à mesure que la valeur économique bâtie sur les ressources de numérotation continuera d’augmenter.
Conclusion
Les entreprises d’IA apprennent à penser de manière stratégique aux puces, à l’énergie, au refroidissement, aux terrains, à la fibre et aux centres de données.
Elles devraient ajouter les ressources de numérotation Internet à cette liste.
Les adresses IPv4, les adresses IPv6, les ASN, BGP, RPKI, le DNS inverse et les enregistrements de registre peuvent sembler être des détails enfouis dans la pile d’infrastructure.
Ce n’est pas le cas.
Ils contribuent à déterminer si les clients peuvent atteindre l’infrastructure que l’entreprise a financée à grands frais.
À mesure que les entreprises d’IA se développent, certaines adresses IP resteront une capacité interchangeable.
D’autres deviendront une identité réseau profondément intégrée.
Le modèle de gouvernance devrait reconnaître cette différence.
Les bonnes questions ne sont pas seulement :
Combien d’adresses IP possédons-nous ?
Combien coûtent-elles ?
Demandez :
Qui les contrôle ?
Qui peut les router ?
Qui peut modifier les assertions de sécurité ?
Quelles dépendances institutionnelles les entourent ?
Peuvent-elles survivre à un changement de fournisseur ?
Peuvent-elles survivre à une défaillance du registre ?
Que se passe-t-il lorsque la réalité opérationnelle et la réalité administrative divergent ?
Tel est le sens profond de la gouvernance des adresses IP.
Le registre devrait protéger l’unicité.
Il devrait protéger l’exactitude.
Il devrait protéger les assertions de sécurité légitimes.
Il devrait rendre lisibles les transferts et les changements de contrôle.
Mais il ne devrait pas devenir propriétaire du destin opérationnel construit autour des numéros qu’il enregistre.
L’infrastructure d’IA dépendra de plus en plus d’une identité réseau stable.
Cette infrastructure mérite la même rigueur de conception que toute autre couche critique :
Aucun point unique de défaillance inutile.
Aucun administrateur irremplaçable lorsque la relève est techniquement possible.
Aucune confusion entre coordination et souveraineté.
Protégez le registre.
Protégez le réseau en fonctionnement.
Protégez le client.
Voilà ce que les entreprises d’IA devraient savoir sur la gouvernance des adresses IP.
Lectures internes sur Heng.lu
- La Déclaration des droits de la coordination de l’unicité
- Primauté du code en production : le correctif nécessaire pour préserver la conception d’origine d’Internet
- Le sophisme de la continuité du registre — protéger le registre de données, pas le gardien
- À propos de LARUS One — L’économie de l’identité réseau, de la continuité client et des revenus des fournisseurs
- Pourquoi i.LEASE existe — et pourquoi la question du courtier est en réalité une question de risque de registre
Lectures externes de référence
- IANA — Ressources de numérotation
- RFC 7020 — Le système de registre des numéros Internet
- RFC 3935 — Énoncé de mission de l’IETF
- RIPE NCC — Qu’est-ce que RPKI ?
- RIPE NCC — Validation de l’origine BGP
Questions fréquentes (FAQ)
1. Pourquoi les entreprises d’IA devraient-elles se soucier de la gouvernance des adresses IP ?Les entreprises d’IA qui exploitent des API, des clouds de GPU, des centres de données, des plateformes d’entreprise et d’autres infrastructures exposées à Internet peuvent devenir dépendantes d’adresses IP publiques et d’ASN. La gouvernance détermine comment ces ressources sont enregistrées, routées, sécurisées, transférées et maintenues en service.
2. Quelles ressources de numérotation Internet les entreprises d’IA devraient-elles suivre ?Au minimum, les entreprises devraient tenir un inventaire des préfixes IPv4 de production, des préfixes IPv6, des numéros de système autonome, des relations avec les registres, des origines de routage, de la configuration RPKI, du DNS inverse et des contrats portant sur les ressources.
3. Quelle est la différence entre une adresse IP et une identité réseau ?Une adresse IP commence comme un identifiant technique. Elle peut devenir une identité réseau lorsque des clients, partenaires, pare-feu, API, systèmes de sécurité et processus de conformité dépendent de la stabilité de cette adresse précise.
4. Les entreprises d’IA devraient-elles acheter des adresses IPv4 ?L’achat peut être pertinent pour des besoins prévisibles à long terme, mais l’acquisition commerciale n’élimine pas les dépendances liées au registre, au routage, à RPKI et à l’administration. La décision devrait donc inclure une analyse de continuité.
5. Les entreprises d’IA devraient-elles louer des adresses IPv4 ?La location peut apporter une capacité flexible et réduire le coût initial. Avant que la production ne dépende du bloc, les entreprises devraient évaluer la provenance de la ressource, la structure du fournisseur, l’autorité de routage, RPKI, le DNS inverse, la réputation, le renouvellement et la continuité.
Catégories: Blog